上游非线性、下游Protein A贵、工厂瓶颈多,mAb生产怎么破?
摘要
这篇发表在mAbs 2026年的综述,系统梳理了单克隆抗体(mAb)生产中的优化策略,重点关注过程模拟、数学优化和人工智能/机器学习(AI/ML)在上下游生物加工中的应用。核心发现:mAb全球市场2023年达2376.4亿美元,预计2030年6790.3亿美元,但生产仍面临上游非线性细胞培养、下游昂贵Protein A层析(占DSP成本约15%)、工厂层面瓶颈三大挑战。
文章从上游优化(培养基/补料、聚集控制、CQA预测)、下游优化(ATPE、膜纯化、蛋白沉淀、PCC/CCTC/PBA-MMC等替代策略)、工厂层面优化(调度、去瓶颈、经济评估)、AI/ML应用(早期开发、上游、下游、数字孪生)四个层面展开,并讨论了数据异质性、高维性、监管约束等挑战。文章为下一代高效、可扩展、低成本的mAb制造提供了数据驱动的路线图。
为什么mAb生产这么难?
做抗体的都知道,单克隆抗体(mAb)是生物制药的绝对主力。从1986年第一个mAb Orthoclone OKT3获批以来,mAb已经广泛用于自身免疫病、炎症、传染病、癌症等治疗。数据说话:2023年全球mAb市场约2376.4亿美元,预计2030年达到6790.3亿美元。
但mAb生产并不简单。这篇综述指出了三大核心挑战:
第一,上游细胞培养行为高度非线性。早期mAb生产优化用"一次一个因素"(OFAT)方法,逐个调整温度、pH等参数,但这种方法忽略了变量间的交互作用,无法捕捉细胞培养的复杂非线性动态。后来用PCA、PLSR等多变量方法降维,但这些线性方法也有局限。
第二,下游纯化昂贵,特别是Protein A层析。Protein A层析是mAb初级捕获的金标准,但它占下游加工(DSP)总成本的约15%。问题还包括低结合容量、配体泄漏、需要高度酸性条件洗脱(可能导致mAb聚集)。这些限制推动了替代纯化策略的开发。
第三,工厂层面的瓶颈。包括成本、周期时间、制造不确定性。传统批处理需要频繁清洁,批次间变异性大,生产周期长,难以规模化和维持低成本。连续生物加工虽然有更高生产力、灵活性和产品质量,但也面临批次管理、停留时间分布、启停阶段管理等挑战。
这篇综述就是要回答一个核心问题:如何用过程模拟、数学优化和AI/ML来突破这些瓶颈,让mAb生产更高效、更便宜、更可靠?
mAb生产全景:上游和下游
在讲优化策略之前,先快速过一下mAb生产的基本流程。Figure 2给出了完整的上下游示意图。
上游(USP):宿主细胞库→接种制备→细胞培养-生物反应器。宿主细胞可以是微生物(胞内产物)或哺乳动物(胞外产物)。mAb生产主要用哺乳动物细胞,特别是CHO细胞,因为它们能进行正确的翻译后修饰。
下游(DSP):生物量去除→Protein A捕获→病毒灭活→精纯层析(AEX/CEX/HIC)→病毒过滤→超滤/透析(UF/DF)→制剂→灌装完成。
上游有四种主要培养模式(Figure 3):
- 批培养(Batch):7-10天,细胞密度2-5×10⁶ cells/mL,生产力0.05-0.1 g/L/day,滴度2-10 g/L。简单、监管路径成熟,但生产力低、设备利用率低。
- 补料分批(Fed-batch):14-21天,细胞密度5-25×10⁶ cells/mL,生产力0.5-1 g/L/day,滴度5-50 g/L。平衡生产力、产量和质量,是目前商业生产的主流。
- 浓缩补料分批(CFB):14-21天,细胞密度50-140×10⁶ cells/mL,生产力1-2 g/L/day,滴度25-80+ g/L。高生产力,但需要细胞截留系统、过滤挑战大。
- 灌流-连续(Perfusion-continuous):30-90+天,细胞密度50-100×10⁶ cells/mL,生产力0.5-3 g/L/day,滴度600-2000+ g。最高生产力、最低单位成本,但资本成本高、复杂、需要连续质量监控。
商业生产通常用5000-25000 L的批或补料分批生物反应器,周期约两周。补料分批是目前的金标准,但灌流和连续加工是未来的方向。
下游的核心是Protein A层析。它基于Protein A配体与mAb Fc区的特异性结合,能让HCP、DNA、内毒素等杂质流穿,而mAb结合在柱上。然后用低pH洗脱,再进行病毒灭活、精纯、病毒过滤、UF/DF。
Figure 4对比了批处理和连续处理在各个单元操作(细胞培养、细胞澄清、初级捕获、精纯、最终浓缩)中的技术选择。连续加工在每个步骤都有对应的技术,比如灌流生物反应器、连续离心/微滤、PCC/SMB/MCSGP层析、连续沉淀、SPTFF等。
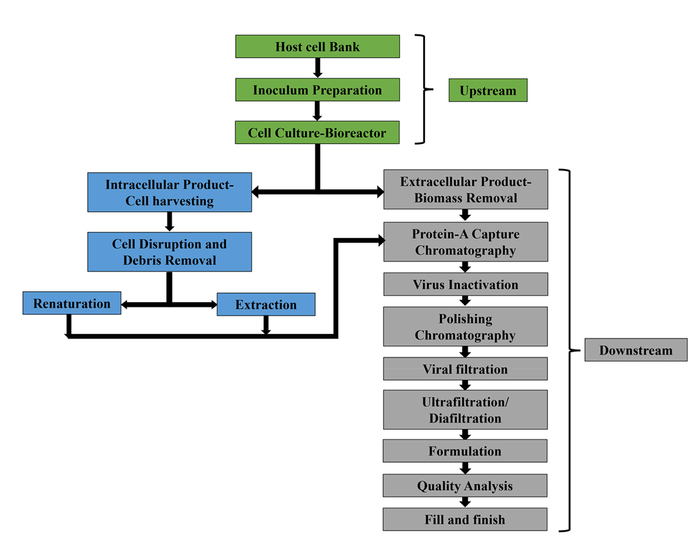
Figure2 上下游生物工艺示意图
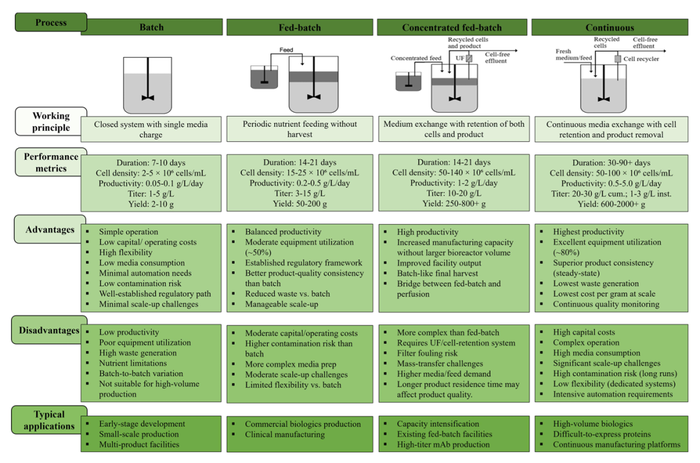
Figure3 四种上游培养模式对比
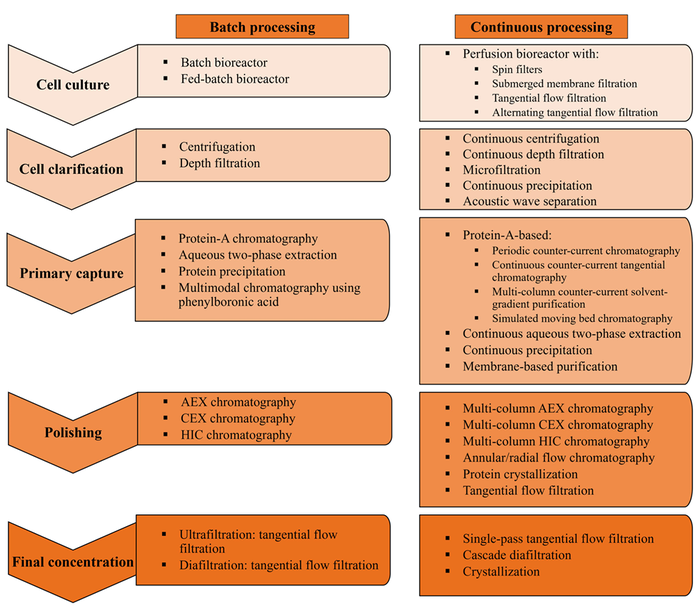
Figure4 批量与连续处理单元操作对比
模拟和数学优化:先算再做
在mAb开发中,技术经济过程模拟和数学优化是互补工具。模拟用于场景评估,数学优化用于决策。
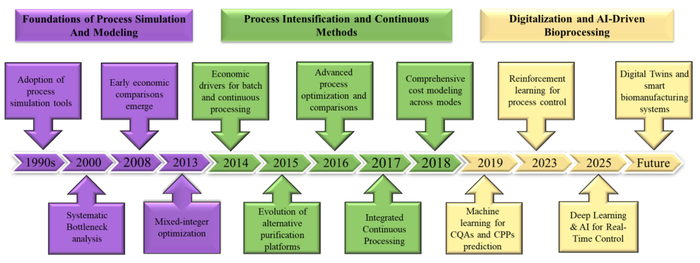
Figure1 mAb 制造中工艺优化策略演变时间线
常用的模拟工具包括SuperPro Designer、Aspen Batch Simulator、BioSolve Process。这些工具用于流程建模和生物制药工艺的经济分析,通过估算商品成本(COG)、周期时间、设备利用率、缓冲需求、消耗品使用和设施瓶颈来评估场景。
但模拟工具有局限:结果依赖于输入假设。在早期工艺开发中,许多关键参数不确定,比如产品滴度、树脂结合容量和寿命、缓冲消耗、劳动力需求、设施利用。因此模拟输出对缓冲制备和储存、清洁要求、树脂再利用和设备共享的假设很敏感。应使用不确定性分析、敏感性分析、随机模拟来评估模拟结论的稳健性。
数学优化方法包括混合整数线性规划(MILP)、混合整数非线性规划(MINLP)、随机规划、元启发式算法。这些方法用于在定义约束下识别最优决策,适用于调度、纯化序列选择、层析柱尺寸、资源分配、成本最小化等问题。常用环境包括GAMS和MATLAB。
数学优化也有局限:可靠的优化需要准确的目标函数、约束和过程关系。简化模型忽略了关键因素,如生物变异性、非线性过程行为、参数不确定性和操作变异性。MILP和MINLP在考虑多产品、多操作、调度决策时计算需求高。因此优化结果应通过实验数据、过程模拟或工业规模研究来验证。
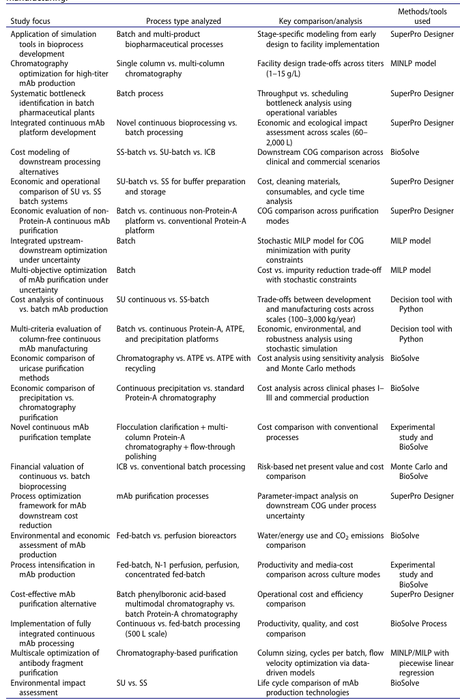
Table 1总结了约20项使用模拟、数学优化和实验方法评估mAb制造过程设计、生产力、调度、去瓶颈和环境绩效的研究。这些研究涵盖了从早期开发到商业生产的各个阶段,包括批vs连续比较、Protein A vs非ProA平台、设施设计、调度优化、经济评估等。
综合这些研究,mAb制造成本由少数技术和经济因素控制。在上游,产品滴度、生物反应器生产力、培养基消耗、生产规模对COG有强影响。在DSP,主要成本和瓶颈因素是ProA树脂成本和寿命、层析容量、缓冲制备和储存、消耗品使用、设施利用和DSP周期时间。
在连续和强化工艺中,增加的整合复杂性在高需求和设施充分利用时更有用。但对于低产量或早期临床阶段,批或单次使用(SU)配置可能更经济。
Table1 使用模拟、数学优化和实验方法评估过程设计的选定研究
上游优化:培养基、补料和质量控制
上游加工的目标是在维持纯度和质量的同时最大化细胞生长和蛋白生产。由于细胞培养系统的复杂和非线性,上游优化需要平衡生产力、过程鲁棒性和关键质量属性(CQA),如聚集和糖基化。
培养基和补料策略是上游优化的核心。培养基优化对细胞存活、生产力和产品质量至关重要。氨基酸、维生素、微量元素等营养成分影响细胞代谢和mAb生产。代谢组学、蛋白质组学、发酵学等技术提供了对细胞营养需求和抑制性副产物积累的洞察。
补料策略也很关键。例如,Hi-End pH控制葡萄糖递送(HIPDOG)技术允许实时调整葡萄糖和营养供应,改善细胞代谢和mAb生产。Jones和Gerogiorgis开发了动态优化框架,用非线性规划优化葡萄糖、谷氨酰胺和补料轨迹,发现葡萄糖操作对mAb滴度和活细胞密度(VCD)影响最大,其次是天冬酰胺。Brinc等用遗传算法在自动化微型生物反应器平台上优化14个哺乳动物补料分批参数,包括培养基、补料和工艺相关变量,减少了实验负担。
产品质量和聚集控制是上游的另一个重点。蛋白聚集影响安全性和治疗效果。研究表明,培养条件如温度和补料策略影响聚集行为。Jones和Gerogiorgis的动态模型考察了温度和补料速率对聚集的影响,发现降低培养温度更有效。Paul等发现将温度降到31°C减少了聚集水平,但不影响整体细胞性能。
另一方面,优化补料速率也很重要。一项动态优化研究显示,提高补料分批系统的流速将mAb滴度增强到5g/L。这些优化应平衡生产力和质量,因为最小化聚集往往涉及不可避免的产量权衡。
CQA控制不仅包括聚集,还包括糖基化谱和电荷变体。影响这些属性的因素包括培养温度、pH、营养可用性、代谢物积累、渗透压和补料策略。糖基化影响生物活性、稳定性、药代动力学和免疫原性,电荷变体影响效价、结合亲和力和稳定性。因此,更高的产物相关变异性可能需要更多精纯层析来分离酸性/碱性变体、聚集体或其他修饰的抗体形式。
模型优化也被用于上游。数学模型已被开发来解释温度、葡萄糖、细胞浓度等参数对mAb生产的影响。例如,PSO和NSGA-II算法结合粒子群优化用于优化温度、生物量、葡萄糖、蛋白质和乳酸浓度,发现最佳补料策略下mAb产量增加5%,反应器操作时间15天。
操作模式选择对上游性能有显著影响。比较研究表明,灌流和补料分批都能实现更高生产力和资源效率。Xu等比较了补料分批、N-1灌注、灌流和CFB模式,发现灌流和CFB实现了更高的体积生产力,分别为2.29和2.04 g/L/day,而补料分批只有0.39-0.49 g/L/day。灌流培养还显示每克抗体的培养基成本相当或更低。
经济和产能考虑:上游过程是制造中的重要成本因素。Harrison等的经济分析报告,上游加工占总制造成本的近三分之二,其中接种制备阶段占近45%。当生物反应器产能充分利用时,分阶段操作能最具成本效益地提高产量。
下游优化:Protein A的替代和强化
下游加工是mAb制造中成本、效率和产品质量的关键。Protein A层析由于对Fc含分子的高选择性,被广泛用作mAb的初级捕获步骤。但ProA仍然是DSP的主要成本驱动因素之一,原因包括树脂成本高、ProA碱性清洗溶液稳定性低、结合容量低、配体泄漏高、需要储存在20%乙醇中(可能需要防火设施)。
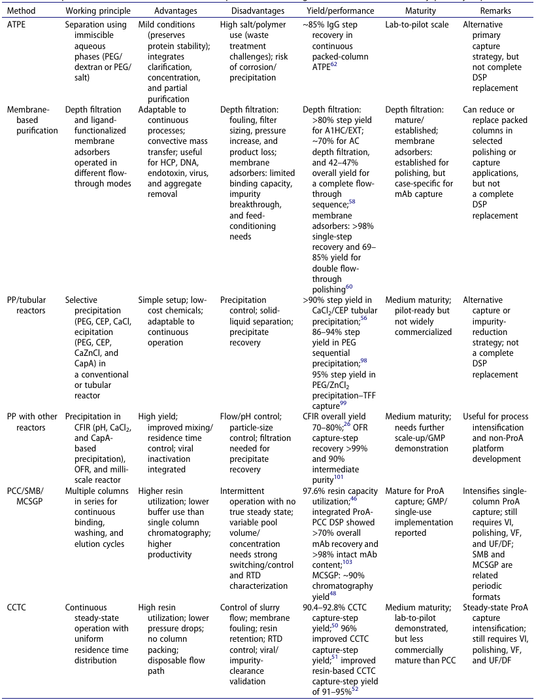
这篇综述详细讨论了多种替代和强化策略(Figure 5、Table 2):
1. 水两相萃取(ATPE):这是一种液-液萃取过程,使用聚合物-盐或聚合物-聚合物体系形成两个水相,在单步中分离蛋白质。常见例子包括PEG/葡聚糖或PEG/盐体系。Rosa等评估了带泵混合器-沉降器的连续填充柱ATPE系统,IgG抗体回收率约85%,总污染物去除超过50%,HCP去除85%。Anupa等开发了连续ATPE-HIC平台,mAb回收率≥80%,中间纯度≥97%,与传统ProA平台相比消耗品成本降低28%。但ATPE的挑战包括大规模采用PEG/盐系统、相形成化学品回收、设备腐蚀、目标产物沉淀、下游相分离需求增加等。
2. 膜基纯化:包括深层过滤、膜吸附剂、流通膜层析。深层过滤常用于澄清和纯化保护,通过尺寸排阻、静电相互作用和疏水吸附去除杂质。膜吸附剂功能化了离子交换、疏水相互作用、混合模式或亲和配体,可用于mAb捕获、中间纯化或精纯。与填充床层析相比,膜基系统提供对流传质、更短处理时间、更低压降、与单次使用和强化操作兼容。Yamada等研究了完全流通纯化(EFTP)技术,某些深层过滤组合对高分子量杂质的去除超过80%。但膜吸附器的挑战包括结合容量低于填充床树脂、突破、污染、进料调节要求、需要验证杂质和病毒清除。
3. 蛋白沉淀(PP):传统沉淀策略随着选择性增加而变得更具酸性,包括辛酸(CapA)和氯化钙(CaCl₂)沉淀用于污染物去除,以及PEG和冷乙醇沉淀(CEP)用于mAb沉淀。为了提高性能和过程一致性,连续沉淀方法已被开发使用管式反应器系统。Hammerschmidt等将之前开发的两阶段沉淀过程转移到连续管式反应器,沉淀步骤产率超过90%,HCP和DNA水平降低。后来的研究使用顺序PEG沉淀和再溶解,单步管式反应器实现86-94%产率。PEG/氯化锌(ZnCl₂)沉淀与管式反应器集成两阶段切向流过滤实现95%产率和97%抗体纯度。但沉淀方法的挑战包括方法特异性的下游挑战,如沉淀剂添加控制、冷却、固液分离、沉淀回收率和再溶解。
4. 周期性多柱层析(PCC):这是一种循环多柱层析方法,用于强化mAb捕获,特别是ProA树脂的再利用。与传统单柱层析不同,PCC在串联中使用多个填充柱,通过加载、洗涤、洗脱、再生和平衡步骤实现更高树脂利用率。Shi等报道三柱PCC连续mAb捕获的捕获步骤生产力为97.6 g/L树脂。PCC的优势包括更高树脂利用率、更低缓冲消耗、连续操作。挑战包括循环洗脱峰可能导致间歇产物流、可变柱体积和浓度,以及VI、抛光、VF、UF/DF的调度需求。
5. 连续逆流切向层析(CCTC):与PCC、SMB、MCSGP等周期性多柱方法不同,CCTC被设计为稳态连续层析方法。CCTC利用浆状形式的层析树脂,通过静态混合装置和中空纤维膜模块允许连续结合、洗涤、洗脱和再生。Dutta等开发了基于ProA的CCTC技术,用商业ProA树脂在浆料中实现90.4%和92.8%的捕获步骤产率,HCP、抗体聚集体和产品纯度与传统填充柱ProA层析相当。后续优化研究通过调整阶段、缓冲液回收、树脂粒度和结合条件,实现了96%的捕获步骤产率和3.4-log HCP减少,缓冲液使用减少40%。CCTC的优势包括稳态操作、高树脂利用率、低压降、减少填充柱处理、与一次性流动路径兼容。挑战包括树脂浆料浓度控制、膜污染、临界通量操作、树脂磨损、过程监测和病毒安全与杂质清除验证。
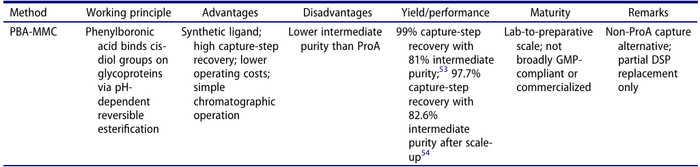
6. 苯硼酸基多峰层析(PBA-MMC):苯硼酸(PBA)是一种合成配体,用于硼酸盐亲和和多峰层析。PBA基系统利用硼酸基团与抗体上顺式二醇含糖链之间的可逆相互作用,以及疏水、静电、氢键和Lewis酸碱相互作用。Santos等评估了PBA层析从澄清CHO细胞上清液中回收IgG,纯化结果约99%捕获步骤回收率,中间纯度97.7%。Rosa等扩大PBA层析规模,进一步纯化得到82.6%的回收率和中间纯度。Grilo等用SuperPro Designer比较了这种替代与ProA纯化过程,发现两者需要相似的资本投资,但PBA-MMC工艺运营成本降低约20%。PBA-MMC的优势包括高捕获步骤回收率、使用合成配体、操作成本低、简单的层析操作。挑战包括杂质清除低于传统ProA捕获、病毒清除、配体泄漏、树脂寿命、对进料变异性的鲁棒性、监管接受度仍在确立中。
Table 2详细比较了这些替代和强化纯化策略,包括工作原理、优势、劣势、产率/性能、成熟度、实验室到中试规模、备注。总体而言,没有单一纯化方法是普遍最优的。选择取决于产率、杂质去除、病毒安全整合、可扩展性、成本、树脂利用、缓冲液和消耗品需求、设施占用、与上游生产力的兼容性。
纯化序列和层析柱尺寸优化也是下游优化的重要部分。Simaria等提出了基于进化算法的多目标优化方法,同时考虑许多决策来简化多产品设施的设计。Liu等开发了MILP模型用于层析柱尺寸优化,评估柱直径、床高、柱数、循环数等决策变量,目标是最小化COG和提高设施适应性。
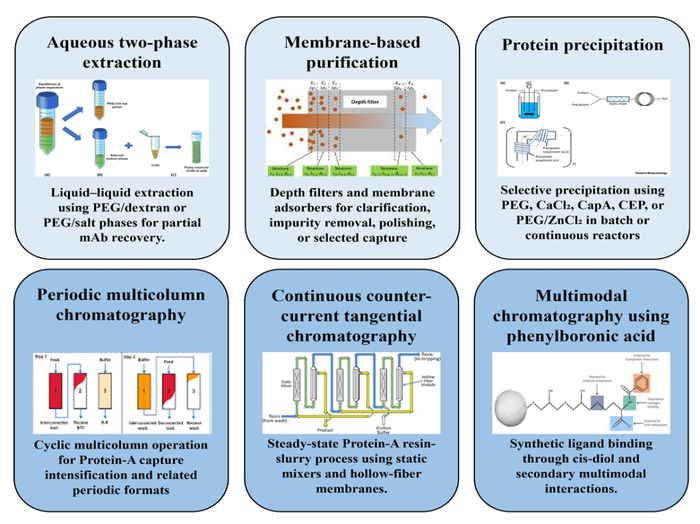
Figure5 mAb初级捕获的替代和强化工艺
Table2 替代和强化纯化策略比较
工厂层面优化:调度、去瓶颈和经济评估
工厂层面优化整合了上下游决策,目标包括成本降低、生产规划和调度、去瓶颈、周期时间减少、产能利用、环境影响最小化。
过程调度在生物制药制造中涉及为每个生产活动分配特定资源、决定批次开始时间、平衡工作量、规划生产多少产品以满足市场需求。Petrides和Koulouris用SuperPro Designer调度不同单元操作,确保生产过程顺利运行,工厂每年运营约330天,完成约21批。
决策工具如元启发式、进化算法和数学优化模型(MILP、MINLP)可用于规划和调度。Kabra等开发了多产品多周期生物制药过程的事件级MILP模型,考虑序列依赖换型、多个需求期、中间体有限货架期、处置成本和惩罚成本。
去瓶颈是识别限制生产吞吐量的步骤、设备或资源,然后修改过程。瓶颈可能因过程配置、生产规模、上游生产力而异。在传统mAb批生产中,上游生物反应器通常是主要瓶颈。Petrides等表明,通过以交错方式操作第一个生物反应器,可以减少瓶颈,周期时间从14天减到7天,整体吞吐量增加。
但随着上游滴度增加,瓶颈可能转移到下游纯化、缓冲液处理或储存。Yang等报道高滴度mAb工艺会导致容量适配问题,因为层析柱、罐和其他纯化资源可能无法处理增加的蛋白负载。在连续生物制药制造中,瓶颈通常转移到下游过程。Ding等表明,当集成连续mAb工艺中上游生产增加时,MCC操作成为过程瓶颈,ProA层析是第一个限制步骤,其次是CEX和AEX层析。
经济评估对于比较替代制造方法和识别具有成本效益的下游纯化配置很重要。mAb生产的主要成本驱动因素是上游生产力、下游纯化效率、设施设计、树脂和消耗品使用、劳动力、设施利用。
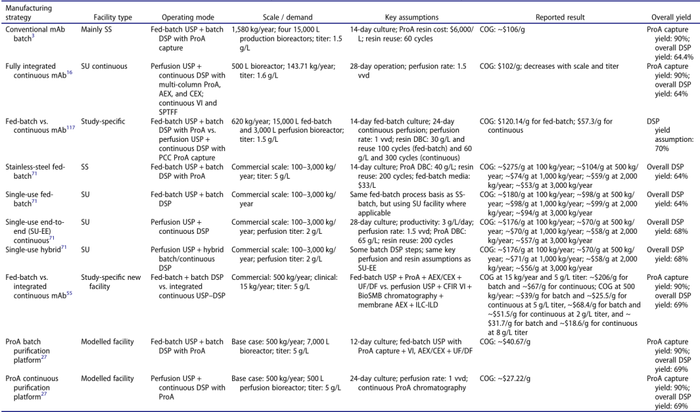
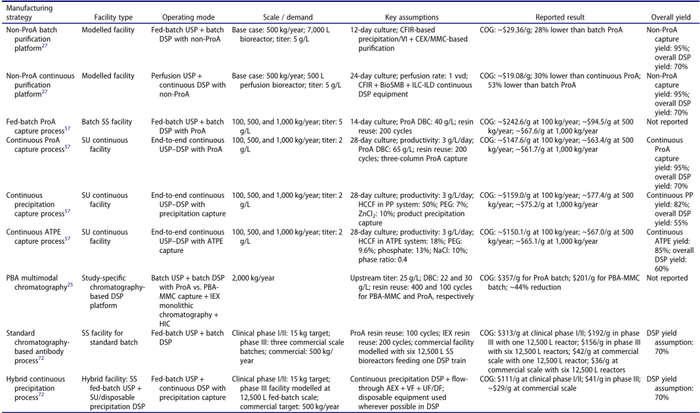
Table 3总结了可用mAb生产平台的经济和操作性能比较。对于传统SS补料分批制造,报告的COG随生产规模和上游滴度变化很大。例如,SS补料分批过程在1580 kg/year、1.5 g/L滴度和ProA树脂替换60次循环后,COG约为106 g/g。在5 g/L滴度和3000 g/L树脂/年、200次循环下,COG从约275 g/g降到53 g/g。
SU补料分批系统主要在小生产规模上显示优势。在相同5 g/L补料分批基础上,SU补料分批制造在100 kg/year和500 kg/year时分别将COG降低约35%和5%。但在1000-3000 kg/year时,报告的SU方法COG更高,SS设施变得有竞争力。
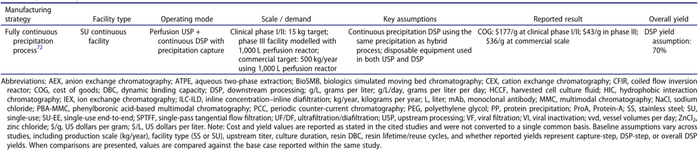
连续和混合系统在中低生产规模上显示更低COG,特别是与SS补料分批相比。例如,在500 kg/year、5 g/L滴度下,端到端连续和混合生物过程与SS补料分批基线相比COG降低35%。在2000-3000 kg/year时,连续和混合SU系统显示与SS补料分批相似或略高(8%)的COG值。
非ProA纯化平台也能降低成本。在500 kg/year、5 g/L滴度下,从ProA切换到非ProA平台将COG降低了33%。用CFIR沉淀的连续非ProA平台与批ProA相比成本进一步降低27%。ProA非ProA平台实现30%的更低成本,连续ProA和连续非ProA分别比批ProA低53%。
环境影响最小化也越来越受关注。研究表明,传统SS工艺高度依赖水和能源注入、清洁操作和清洁蒸汽。SU设施通过用一次性SS设备替代固定在位系统,减少了水消耗、能源消耗和环境影响。过程质量强度(PMI)、E因子和CO₂排放是衡量环境绩效的常用指标。
Table3 mAb生产过程的经济和操作比较
AI和机器学习:从早期开发到下游控制
这篇综述用了大量篇幅讨论AI/ML在mAb生产中的应用。AI结合了基于计算机的分析和数据驱动决策,ML作为AI的一个分支,从数据中学习模式并开发预测、分类、优化和控制的数学关系。
AI在早期生物过程开发中的应用(Table 4):
- 早期可开发性筛选和部署准备:AI/ML模型用于在发现阶段早期识别潜在的治疗候选物或降解/聚集位点。计算工具如abYmod、AbPred、CamSol、RosettaAntibody、QikProp等常用于生物制药计算。Puranic等建议将这些方法整合到抗体开发中,可以提供更知情的候选物选择并减少大量资源和时间。
- 基于序列和蛋白质语言模型的可开发性预测:序列基预测是早期抗体开发中最有用的AI应用之一,因为氨基酸序列数据在发现的最早阶段就可用。Chen等用监督ML流水线预测氨基酸序列的开发能力指数,数据集包含超过2400个抗体,SVM表现最好,AUROC为0.86。蛋白质语言模型(PLMs)也被用于几个早期可开发性属性,如聚集倾向、溶解度、保留时间和浓缩粘度。
- 生物物理和制剂相关属性预测:AI也被用于预测实验可测量的生物物理和制剂相关属性,包括熔点、聚集起始温度、溶解度、聚集速率、粘度和基于层析的可开发性指标。Gentiluomo等开发了人工神经网络策略,仅基于氨基酸组成和配方条件预测抗体的生物物理性质,在144个样本上测试,熔点预测R²=0.98,聚集起始温度R²=0.94。
- 特异性和脱靶结合风险预测:可开发性评估不限于物理稳定性和制剂行为,其他因素如脱靶结合、多特异性和多反应性也会影响抗体清除、功效、毒性和免疫原性。Yu等用PLM基模型预测多反应性,在杆状病毒颗粒结合测定的实验结果上测试,进化标度模型(ESM-2)基PLM实现了最佳验证AUROC 0.906和测试AUROC 0.838。
ML在上游生物加工开发中的应用(Table 5):
- PAT兼容的CQA和过程性能预测:Narayanan等提出基于PLSR的决策树(DT)方法,用多变量数据分析(MVDA)预测细胞培养物的CQA。在第一个数据集(84个补料分批运行,3.5 L生物反应器规模)中,黑盒模型将最终滴度的预测误差从112.83降到73.33 mg/L,最终VCD从0.93降到0.60×10⁶ cells/mL。
- 基于性能的建模(PBM):Schmiderger等提出PBM方法,用过程数据如DO、pH、CO₂、VCD、活力、渗透压和关键代谢物预测12个质量属性。RF模型表现优于SVM、PLSR和RBF-ANN,最终产物浓度R²=0.95,产物I R²=0.87,产物II R²=0.92。
- 数据智能方法:Gangadharan等提出数据智能方法预测上游mAb制造过程的性能,数据集来自AstraZeneca的过程开发,包括106个CHO培养运行,规模从实验室(5 L)到商业生产(500 L),时间跨度7年。特征选择和模型优化后,RMSE从1363.96降到710.21,对应52.07%的减少。
- 混合和数字孪生模型:混合模型结合过程知识和数据驱动预测,机制模型提供生物可解释性,数据驱动模型捕获复杂非线性关系。Wang等提出基于迭代学习的鲁棒优化系统,用于连续mAb生产中的培养基优化,案例研究使用23个细胞外代谢物和126个mAb作为输入变量,与基础培养基相比,收获的mAb速率从3.7010增加到4.3396 pmol/(cell·day)。Park等开发了用于多步预测哺乳动物细胞培养谱的数据驱动模型,研究使用24个补料分批,最佳模型实现葡萄糖消耗MAPE为5%,VCD为3%,氨为3%,IgG/mAb滴度为3%。
- 用于控制和自适应优化的高级AI:Zheng等开发了结合卷积神经网络(CNN)和长短期记忆(LSTM)网络的混合深度学习(DL)模型,用于计算mAb生产,模型用50个生产批次、不同细胞系和50-2000 L生物反应器规模的工业数据开发,mAb滴度预测RMSE为0.412 g/L,R²=0.947。特征分析显示pH、温度和DO是影响mAb生产的关键因素,在硅优化中预测pH增加27.9%,体积生产力增加28.1%,mAb滴度从3.1增加到4.1 g/L。
- 强化学习(RL):Gupta等用近端策略优化(PPO)算法调整进料流速来控制生物反应器中的mAb浓度,与深度确定性策略梯度(DDPG)和双延迟深度确定性(TD3)相比,PPO显示更低RMSE操作,在三个案例研究中RMSE分别为228.4、225.3和224.2,而DDPG为215.3、214.0和216.1。Sarna等开发了用于灌流mAb生物反应器的详细过程模拟模型,用模型预测控制(MPC)策略最大化最终产物形成,与现有PI控制器相比,约束子空间MPC将最终产物从97 mg/day增加到178 mg/day,对应83.5%的改进。
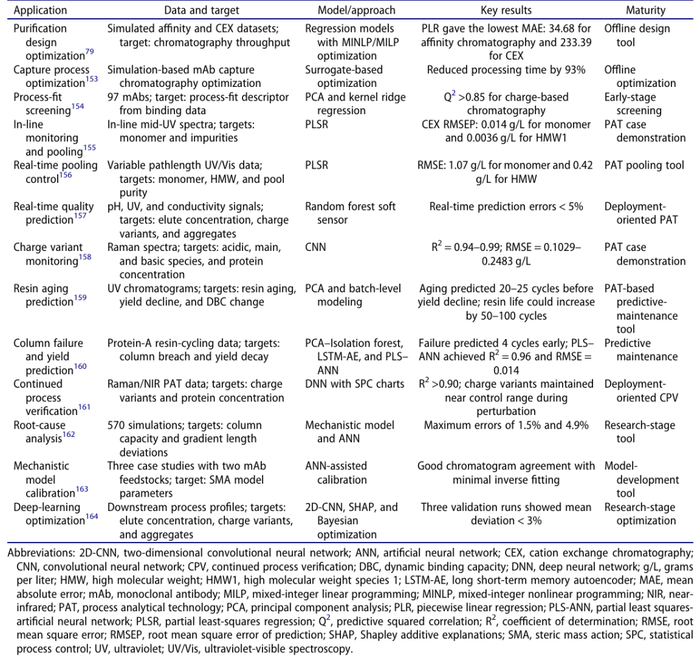
ML在下游加工中的应用(Table 6):
- 数据驱动的纯化开发:Liu等开发了数据驱动优化方法,用于跨多个规模的抗体片段纯化,用流速、质量负载和柱高等作为输入参数预测层析变量,制造规模数据集包含3081个亲和层析(AC)样本和2847个CEX样本,PLR表现最好,AC的MAE为34.68,CEX为233.39。
- PAT监测和实时池预测:Brestrich等用PLSR模型实时监测层析运行中的批间变异性,在线UV吸收光谱同时记录生成过程数据。验证的PLS模型显示分析聚集体(HMW)和低分子量(LMW)级分的RMSE分别为0.014 g/L和0.0036 g/L。这种方法可支持实时池决策。
- 实时质量预测:Nikita等应用ML模型从常规可用的过程传感器如pH、UV和电导率信号实时预测关键过程属性,在实时验证运行中,RF预测ProA洗脱液中的酸性电荷变体、CEX浓度和聚集体百分比的误差分别为4.761%、2.630%、2.357%和2.881%。最终随机森林模型对所有预测属性的误差均低于5%。
- 自动化控制和预测性维护:Ramakrishna和Vercauteren提出用PCA分析UV层析数据和批级建模(BLM)实现ProA树脂老化,研究涉及不同mAbs,这种方法可在观察到产量下降之前20-25个循环触发树脂更换,从而将额外的ProA树脂寿命增加约50-100个循环。
- 高级AI和混合建模:Wang等应用混合建模技术结合机制层析建模与ANN,分析关键过程偏差如柱容量和洗脱梯度长度,这种方法识别了洗脱梯度长度4.9%和柱容量1.5%的预测误差之间的基本相关误差。Vollmer等证明了使用ANN基校准加速机制模型开发,用于CEX层析,ANN基工作流提供了可接受的参数估计,实验和模拟层析图之间显示出良好一致性,并且与传统的逆拟合方法相比,通过同时高和低密度数据工作流将校准工作量减少了约一倍。
模型生命周期部署考虑:虽然AI和ML模型在早期开发、上游生物加工和下游加工中的应用越来越多,但在GMP相关环境中的使用需要仔细的生命周期管理。FDA过程验证指南、ICH Q9(R1)质量管理、ICH Q10制药质量体系、FDA和EMA的AI/ML监管指南都提供了框架。模型用于GMP制造、过程控制、CPV或发布相关决策时,需要更严格的验证、文档、变更控制程序和发布风险。模型部署后应持续监测性能是否有漂移,任何重新校准、再训练、限制操作范围或返回决策支持仅用都应遵循预定义的治理和变更控制程序。
Table4 早期mAb开发中AI/ML应用总结
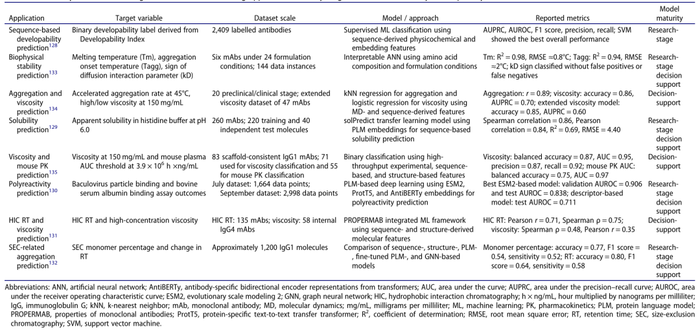
Table5 上游mAb生物加工中ML应用总结
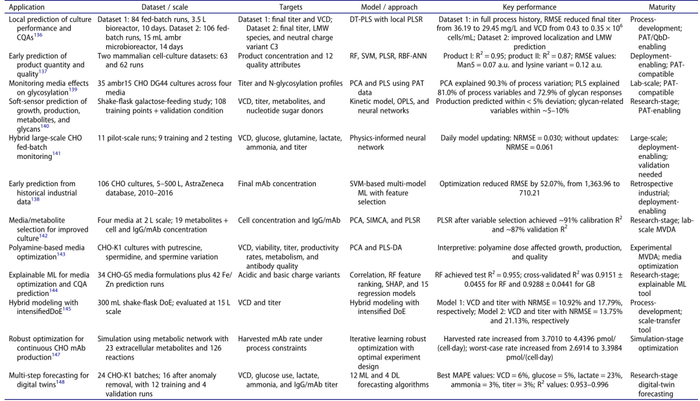
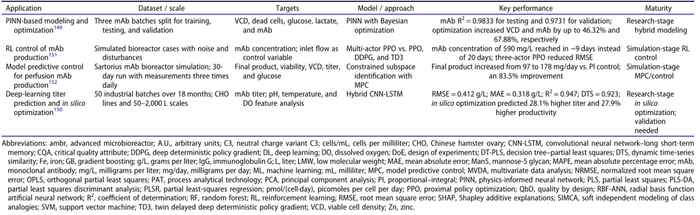
Table6 下游mAb加工中AI/ML应用概述
挑战和未来展望
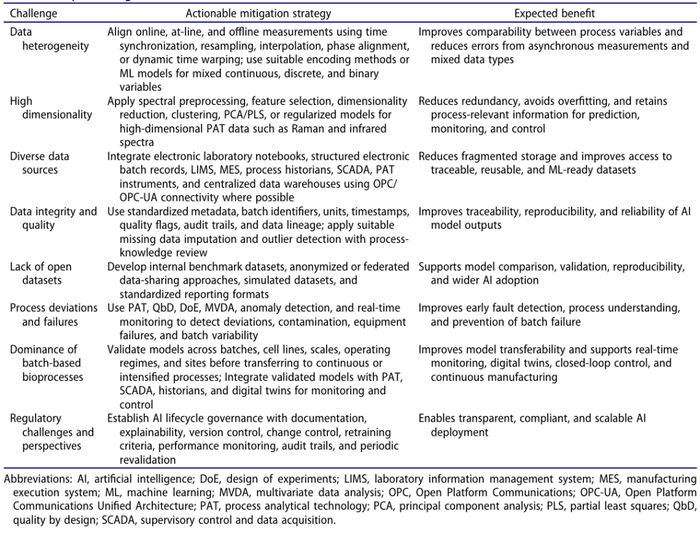
这篇综述也诚实地讨论了AI在生物制药过程中实施的主要挑战(Table 7):
1. 数据异质性:生物过程数据的异质性是mAb生产的主要障碍之一,因为测量时间尺度和数据类型不同。在线参数如pH、温度和DO实时记录,而离线参数如VCD和产物浓度则定期测量。不同解决方案如用交替采样间隔训练ML模型、时间变形重采样、插值、编码方法或ML模型用于混合模态都被提出。
2. 高维性:现代生物过程分析使用PAT工具如拉曼和红外光谱,可以记录数百个变量。ML算法在处理与高维特征相关的数据时面临挑战,特别是当可用于训练ML模型的数据量有限时。特征选择和降维技术如光谱预处理、特征选择、聚类、PCA/PLS和正则化模型可用于处理高维数据。
3. 多样数据源:生物制药过程产生多种类型的数据,具有多样性、分布和多结构格式的特点。这给自动化模型构建带来了重大困难。实际解决方案涉及将结构化电子存储系统与强大的ML模型集成,包括数据仓库、过程历史记录、LIMS、MES、SCADA和OPC-UA基于数据传输系统。
4. 数据完整性和质量:ML模型在生物加工中的有效性取决于数据质量和完整性。缺失数据是关键问题之一,可能由于传感器故障、不规则采样率、实时数据记录错误和人为因素而发生。常用的缺失数据处理方法包括移除不完整样本、插补或使用可以处理部分数据集的ML算法。异常值也会影响ML模型的结果,常用的异常值检测方法包括统计方法、基于偏差的方法和假设检验程序。
5. 缺乏开放数据集:缺乏公开可用的基准数据集是开发生物加工ML方法的主要障碍之一。开放数据集的缺乏使不同ML模型和方法在相同条件下的过程比较变得复杂。为了解决这个问题,可以开发内部基准数据集、匿名化或联邦数据共享方法、模拟数据集和标准化报告格式。
6. 过程偏差和失败:过程中的变化、小设计空间和批次失败使得难以在生物制药制造中保持一致的数据。缺乏对过程变异性的充分理解会导致数据质量差异和过程控制复杂性。QbD和PAT促进了统计方法在监测和改进过程中的应用,DoE和MVDA可以帮助识别关键过程参数并理解变异性来源。
7. 批处理主导:生物制药制造仍然主要基于批处理过程。因此,顺序单元操作在CPP中执行,这会改变最终产物的过程和CQA条件。虽然批处理有助于控制突变时间和限制并保持产品质量,但它也与增加的生产时间和低可扩展性相关。连续生物加工允许实时控制和优化,减少过程变异性并保持一致的产品质量,但需要许多先进的PAT和可靠的预测模型来确保连续操作。
8. 监管挑战:生物制药和医疗行业由于更严格的法规、围绕创新过程的不确定性和缓慢的审批过程,在采用AI和ML方面一直较慢。获得ML增强制造过程的监管批准通常比传统方法更困难,因为目前ML模型可以比传统方法更有效,但在验证方面缺乏监管标准。为了克服这些监管问题,生物制药公司、监管机构、政府和学术机构可能需要共同努力开发有效的AI治理模型。
未来展望:
- Industry 4.0和数字孪生:生物制药制造正朝着完全数字化、自动化和数据驱动的系统发展。数字孪生是结合机制模型与实时测量和ML的生物过程在线模拟,预计将成为连续监测、预测控制和快速问题解决的关键工具。
- 多组学和基因组学:多组学技术和高通量分析的日益普及可能进一步改善生物过程数据。将ML与基因组学、蛋白质组学和代谢组学信息相结合可能支持更快的培养基设计、更精确的细胞系工程和改进的产品质量属性预测。
- 量子计算:量子计算模型可以增强分子模拟,加速设计空间探索,并加强对CPP和CQA的预测。然而,其在工业生物制造中的应用仍处于早期和探索阶段。
- 可持续性:未来的创新还应考虑可持续性。ML优化可以帮助最小化废物、能源和环境影响。随着生物制造向更大的整合和智能化发展,ML可能不再仅仅是一个有用的工具,而是成为促进自主、自我优化过程的核心技术。
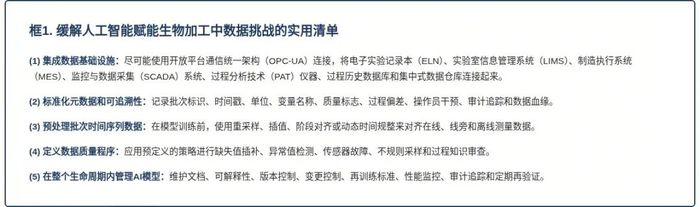
Box 1给出了缓解AI赋能生物加工的实用清单:(1) 集成数据基础设施;(2) 标准化元数据和可追溯性;(3) 预处理批时间序列数据;(4) 定义数据质量程序;(5) 在整个生命周期管理AI模型。
Table7 AI赋能生物加工的主要数据相关挑战、缓解策略和预期收益
Box 1 缓解AI赋能生物加工的实用清单
做抗体的人怎么看
从抗体专家的角度,这篇综述的发现很有参考价值。
第一,模拟和数学优化是"先算再做"的好工具,但不能替代实验。这篇综述详细介绍了SuperPro Designer、Aspen Batch Simulator、BioSolve Process等模拟工具,以及MILP、MINLP等数学优化方法。这些工具可以在早期阶段快速评估不同工艺方案的经济性和可行性,减少实验负担。但模拟结果高度依赖输入假设,数学优化需要准确的目标函数和约束。做抗体的人都知道,模拟和优化给出的是"最优解的方向",不是"最优解本身",最终还是要靠实验验证。
第二,上游优化的核心是平衡生产力和质量。这篇综述花了大量篇幅讨论培养基优化、补料策略、聚集控制、CQA预测。做抗体的都有体会,提高滴度不难,难的是在提高滴度的同时保证产品质量。聚集、糖基化、电荷变体这些CQA都受培养条件影响,而且往往与生产力存在权衡。这篇综述提到的多目标优化、动态补料、模型预测控制等方法,都是为了在生产力和质量之间找到最佳平衡点。
第三,下游纯化的替代策略很多,但Protein A短期内仍是金标准。这篇综述详细介绍了ATPE、膜基纯化、蛋白沉淀、PCC、CCTC、PBA-MMC等多种替代和强化策略。这些策略各有优势,比如ATPE成本低、膜基纯化处理时间短、PCC树脂利用率高、CCTC稳态操作、PBA-MMC用合成配体。但这些替代策略大多还处于实验室到中试规模,在回收率、杂质清除、病毒安全、可扩展性、监管接受度等方面还需要更多验证。Protein A层析虽然贵,但经过了几十年的工业验证,短期内仍是mAb初级捕获的首选。不过,PCC、CCTC等强化策略通过提高树脂利用率和降低缓冲消耗,可以在Protein A平台上显著降低成本,这些更值得关注。
第四,AI/ML是未来的方向,但离真正落地还有距离。这篇综述用了大量篇幅讨论AI/ML在早期开发、上游、下游的应用,从可开发性预测到CQA预测,从数字孪生到强化学习控制,覆盖面很广。这些研究展示了AI/ML的巨大潜力,比如CNN-LSTM模型预测mAb滴度R²=0.947,RF模型预测CQA误差低于5%,PPO算法控制生物反应器mAb浓度。但这些研究大多还处于研究阶段,使用的是内部、小数据集,模型的可迁移性、可解释性、在GMP环境中的验证和监管接受度都是挑战。这篇综述也诚实地指出,数据异质性、高维性、缺乏开放数据集、批处理主导、监管约束等都是AI落地的障碍。
第五,连续制造是趋势,但需要全链条的配套。这篇综述反复提到连续生物加工的优势——更高生产力、更低成本、更好的产品质量一致性。但连续制造不是简单地把批处理改成连续,它需要上游灌流、下游连续层析、实时PAT监测、数字孪生控制、全链条整合的配套。做抗体的人都知道,连续制造在技术上已经可行,但在经济上是否划算,取决于生产规模和需求。这篇综述的经济分析也表明,连续和混合系统在中低生产规模上显示更低COG,但在大规模商业生产中,SS补料分批仍然具有经济吸引力。
对实际工作的启示:
1.早期工艺开发:用模拟工具快速评估不同方案,用DoE和MVDA识别关键参数,减少实验负担
2.上游优化:关注培养基和补料策略的动态优化,用模型预测CQA,平衡生产力和质量
3.下游优化:短期用PCC、CCTC等强化策略提高Protein A效率,长期关注替代纯化策略的成熟度
4.AI/ML应用:从PAT监测和CQA预测等低风险场景开始,积累数据和经验,逐步向实时控制和数字孪生推进
5.数据基础设施:建立标准化的数据采集、存储和管理系统,这是AI/ML落地的基础
mAb生产已经走过了四十年,从最初的批培养到现在的补料分批和灌流,从OFAT优化到现在的多变量分析和AI预测,生产力提升了上百倍。但对于更高产量、更低成本、更复杂分子的需求,我们还需要更多创新。这篇综述给了我们一个全面的路线图——模拟和数学优化、上游和下游工艺强化、AI/ML和数字孪生、连续制造,这些方向值得重点投入。做抗体的人,应该关注这些趋势,把它们用到实际的工艺开发和生产中。
文章内容来自药时空,流程工业整理编辑,责任编辑:邵丽竹,审核人:何发
版权声明:本文由“制药工艺与装备”平台整理发布,版权归原作者所有,如有侵权请联系删除。邮箱:cuifangfei@vogel.com.cn。
邵丽竹
何发
热点文章
-
2026(第十八届)弗戈制药工程论坛
2026-08-31
-

2025年度中国医药工业主营业务收入前100位企业发布!哪家企业上榜?
2026-07-13
-

论医药洁净区空间消毒 / 灭菌的常用方法
2026-06-26
-

浅谈制药智能配液系统的设计
2026-06-24
-

2026(第十八届)弗戈制药工程论坛日程首发 | 1大主论坛+8场分论坛
2026-07-24
-

全球TOP10药企2026年第二季度财报解读:礼来断层领跑,行业分化加剧
2026-08-03
-

无菌制剂生产线污染控制策略研究与思考
2026-07-16
评论
加载更多