冻融 PVA 水凝胶刚度预测:从实验设计到机器学习,如何提高小样本建模的可靠性?
美国北达科他大学团队提出一种结合统计实验设计(Design of Experiments,DoE)与机器学习(Machine Learning,ML)的建模框架:先通过全因子设计和 Box–Behnken 设计系统采集数据,再利用多种机器学习算法预测压缩模量,并通过真实实验验证模型的泛化能力。研究进一步采用合成数据扩充设计空间,考察小样本条件下模型性能的稳定性。
1.方法:先定义设计空间,再训练预测模型
水凝胶配方与参数设置。 研究采用 PVA、κ-卡拉胶(κ-carrageenan,κCA)和聚乙二醇(PEG)构建冻融水凝胶体系。其中,κCA 浓度固定为 0.12%(w/v),PEG 添加量固定为 0.25%(v/v),重点考察 PVA 浓度及冻融工艺条件对力学性质的影响。
PVA 设置三个浓度水平:3.49%、5.24% 和 6.98%(w/v);冻结温度设为 −10 ℃、−45 ℃和 −80 ℃;解冻温度设为 25 ℃或 37 ℃;冻融循环次数为 3、5 或 7 次。
样品制备。 PVA 溶于 200 mL 去离子水,在约 70 ℃、250 rpm 条件下搅拌 6 h,随后加入 κCA 和 PEG。配制好的溶液分装至 24 孔板,每个条件设置至少 4 个重复。样品在对应温度下完全冻结后进行解冻:25 ℃条件下解冻 10 h,37 ℃条件下解冻 90 min。完成冻融后,样品在去离子水中平衡,以尽量统一后续测试前的含水状态。
实验设计。 作者采用两种统计设计方法。其一是全因子设计(Full Factorial Design,FFD),对四个因素在两个水平上的组合进行系统考察,共包含 16 个实验条件,可用于评价主要效应和两因素交互作用。其二是 Box–Behnken 设计(BBD),进一步研究冻结温度、PVA 浓度和冻融循环次数与刚度之间的响应曲面关系,以二次回归项描述非线性和曲率。两种设计的作用不同,FFD 用于识别主要影响因素及其交互作用,BBD 用于进一步刻画关键因素共同变化时的非线性响应。
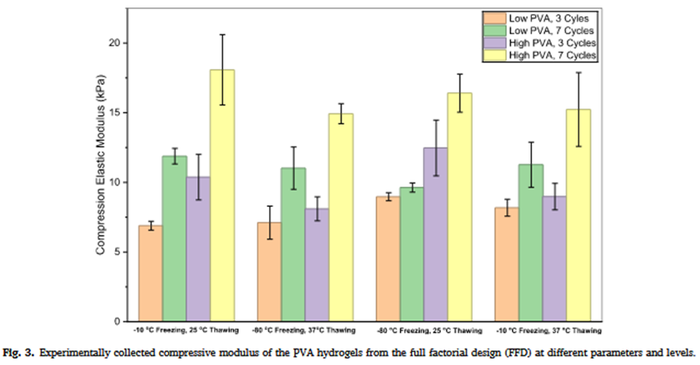
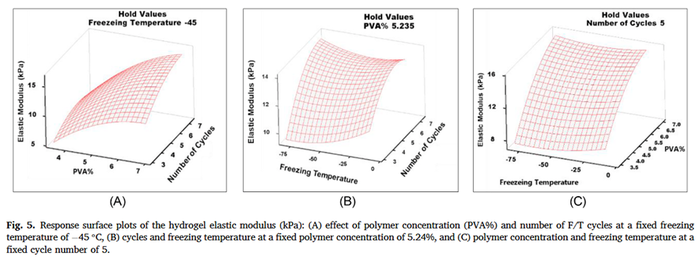
刚度测量与结构表征。 压缩测试采用配备 500 N 载荷传感器的万能试验机,预载荷为 0.13 N,压缩速度为 1 mm/min,最大应变达到 40%。压缩模量由约 0%—10% 应变范围内应力—应变曲线的线性斜率计算获得。
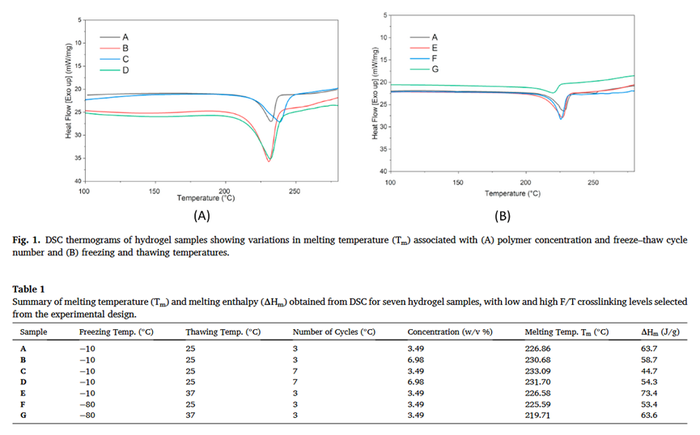
为解释宏观力学变化,作者还采用差示扫描量热法(DSC)分析熔融温度与熔融焓,并通过扫描电子显微镜(SEM)观察冻干水凝胶的孔隙形态和网络结构。该组合将力学响应与热性质、微观结构联系起来,为模型识别出的参数效应提供材料学依据。
2.模型比较:高训练集 R² 并不代表高预测可靠性。
作者将 FFD 与 BBD 的数据合并,得到 128 个实验数据点,其中 102 个用于训练,26 个用于测试。随后比较四种算法:随机森林(RF)、支持向量回归(SVR)、高斯过程回归(GPR)和极端梯度提升(XGBoost)。模型使用默认超参数进行比较,并通过交叉验证评估稳定性。
整合实验数据上的训练集与测试集表现如下:
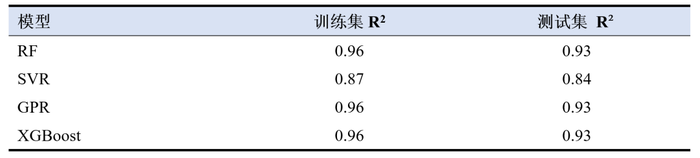
这组结果说明,RF、GPR 和 XGBoost 在已有数据上均能够较好地拟合刚度变化。但作者进一步设置了 4 个真实实验验证点,对模型在特定新条件下的表现进行考察,结果明显不同:RF 的验证集 R² 为 0.124,SVR 为 0.70,GPR 为 0.70,XGBoost 仅为 0.08。
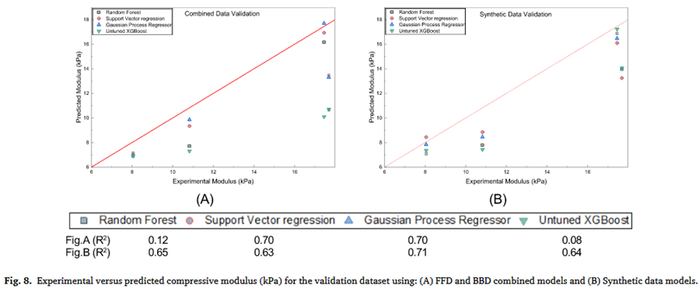
也就是说,训练集与测试集表现良好的树模型,在独立验证点上并没有维持同样的预测能力,而 SVR 和 GPR 的表现相对稳定。需要注意,验证点只有 4 个,且原文说明这些验证点是特意选在设计空间边界(deliberately selected near the boundaries of the design space),边界处非线性增强与饱和效应会加大预测不确定性;R² 又会受单个样本误差的显著影响,因此这些数值主要反映模型在这组特定验证条件下的表现,不能直接作为普遍泛化能力的定论。
3.关键结果:传统回归为什么容易低估高刚度区域?
PVA 浓度与冻融循环次数是重要的刚度调控因素——FFD 标准化效应正态图(原文 Fig. 4C)显示 PVA 浓度与循环次数的正效应最强,解冻温度落在负侧(25 ℃ 比 37 ℃ 更有利于结晶、刚度更高)。 实验发现,较高 PVA 浓度结合更多冻融循环时,压缩模量通常达到较高水平,部分条件下达到或超过 15 kPa;低浓度且仅冻融 3 次时,模量通常低于 10 kPa。
其原因与聚合物链缠结、氢键作用和结晶微区形成有关。冻融过程能够促进 PVA 链在聚合物富集区域内形成物理交联结构,从而增强网络刚度。但随着浓度和循环次数提高,链段重新排列的空间逐渐受限,力学增强可能呈现非线性甚至趋于饱和。
DSC 与 SEM 结果支持了这一总体趋势:不同工艺条件会改变结晶相关热性质与孔隙网络形态;更高的 PVA 浓度通常对应更致密、孔隙更小的网络。
真实验证显示,回归模型在高刚度条件下存在系统性低估。 在冻结温度 −10 ℃、解冻温度 25 ℃、PVA 浓度 6.98%、冻融 4 次的条件下,FFD 模型预测压缩模量为 12.41 kPa,95% 置信区间为 11.70—13.13 kPa,而实测值为 17.69 kPa。BBD 模型在相同条件下预测为 14.21 kPa,95% 置信区间为 13.19—15.22 kPa,仍低于实测值。
这表明,即使响应面模型纳入了二次项,在高刚度区域仍可能无法充分描述复杂的强化效应。机器学习的优势在于能够通过更灵活的函数关系捕捉非线性,但是否真正提高预测可靠性,仍需依赖独立实验验证。
4.合成数据:能否改善小样本条件下的预测稳定性?
为缓解真实实验数据有限的问题,作者根据 BBD 二次回归模型随机生成 1000 个合成数据点,并在解冻温度固定 25 ℃、冻结温度与循环次数限定于实验范围内的条件下加入随机扰动,再用这些数据训练相同的四种机器学习算法。
合成数据模型的训练集、测试集和五折交叉验证结果如下:
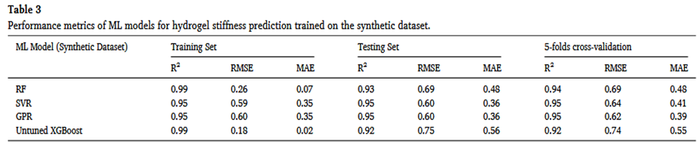
RF 和 XGBoost 获得了很高的训练集 R²,但测试和交叉验证表现略有下降;SVR 和 GPR 则在不同评价环节之间表现得更加一致,显示出较好的稳定性。
进一步使用相同的 4 个真实实验验证点进行比较,合成数据训练模型的 R² 分别为:RF 0.65、SVR 0.63、GPR 0.71、XGBoost 0.64。相比直接使用整合实验数据训练时 RF 的 0.124 和 XGBoost 的 0.08,二者在这组验证点上的表现均有所改善。GPR 的验证 R² 由约 0.70 提高至 0.71,仍呈现相对稳定的结果。
不过,合成数据并不等于新增的真实实验。由于这 1000 个数据点来源于已有 BBD 回归模型,它们能够加密模型定义的响应曲面,却也可能继承原始模型的函数假设和系统性偏差。因此,合成数据更适合用作辅助建模和插值稳定性分析,不能取代独立的材料制备与力学测试。
5. 适用边界:预测模型仍需要更严格的外部验证
本文展示了 DoE–ML 框架在特定 PVA 基冻融水凝胶体系中的潜力,但有三点限制值得关注。
第一,真实实验验证仅包含 4 个点,样本数量不足以全面检验模型在整个参数空间内的可靠性,尤其是高刚度边界区域。后续需要扩大验证规模,并覆盖更多工艺组合。第二,模型未进行系统性的超参数优化,也缺乏充分的独立外部数据集验证。因此,目前的模型表现还不能代表经过全面优化后可能达到的最佳性能。第三,预测框架主要适用于本文研究的 PVA 基物理交联体系和既定设计范围。若将其推广至其他聚合物组成、化学交联体系或新的工艺条件,需要补充材料特异性的实验数据并重新校准模型。
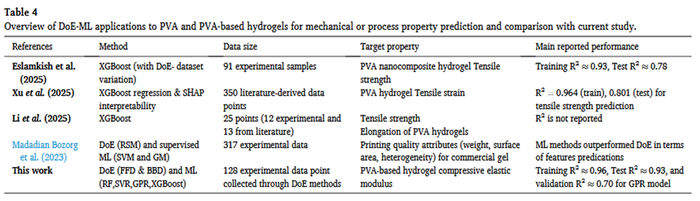
6. 对实验设计和材料建模的启示
这项研究最值得借鉴的并非某一种算法的 R² 更高,而是完整的研究路径:通过 DoE 提高有限实验数据的信息量,以 DSC 和 SEM 对模型识别的规律进行材料学解释,再通过测试集、交叉验证和真实实验检验预测结果。
对于数据量有限、实验成本高且存在多因素耦合的材料体系,机器学习可以帮助研究人员减少盲目试错,但它不能替代实验设计和独立验证。只有当模型在未参与训练的真实实验条件下仍能提供可靠预测时,数据驱动建模才真正具有指导配方优化和工艺设计的价值。
参考文献:
Al-Goraee, A. M., Alshami, A. S., Ghaly, M., et al. From experimental design to data-driven prediction: Modeling the stiffness tunability of freeze–thaw PVA-based hydrogels. Journal of the Mechanical Behavior of Biomedical Materials, 2026, 177: 107380. https://doi.org/10.1016/j.jmbbm.2026.107380
文章内容来自QbD药PAT,Pharma TEC制药业整理编辑,责任编辑:邵丽竹,审核人:何发
版权声明:本文由“制药工艺与装备”平台整理发布,版权归原作者所有,如有侵权请联系删除。邮箱:cuifangfei@vogel.com.cn
邵丽竹
何发
热点文章
-
2026(第十八届)弗戈制药工程论坛
2026-08-31
-
2026中国生物医药全景报告:规模破7万亿,创新药正式出海逆袭
2026-08-31
-
刚刚,国家局 GMP 新附录,来了!
2026-09-02
-
A 级是几级?一张表看懂GMP洁净区 A/B/C/D 四个级别与设计要求
2026-08-26
-
AI for Science爆发!中国30家硬核企业全盘点
2026-09-14
-
无菌药品生产洁净环境确认与环境监测:法规要求及实操解析
2026-08-27
-
诺和诺德,宣布改名:沿用百年的“Nordisk”正式退场!
2026-09-15
评论
加载更多